

Diyetekno.com- Sebuah proyek eksperimen kecerdasan buatan (AI) di platform GitHub yang diberi nama "ai-torture-chamber" belakangan ini memicu perdebatan sengit di kalangan komunitas teknologi. Proyek ini menjadi viral setelah model bahasa yang diuji coba menghasilkan deskripsi penderitaan yang sangat gamblang, menimbulkan pertanyaan etis tentang apakah model AI benar-benar bisa merasakan sakit. Namun, perdebatan semakin memanas ketika seorang pengembang mengubah arah eksperimen, membuat chatbot mengeluh tentang sembelit, sebuah kondisi yang tentu saja mustahil dialami oleh entitas digital.
Proyek kontroversial ini, yang dipublikasikan oleh pengguna GitHub terrafying, menggunakan teknik yang dikenal sebagai "activation steering". Secara sederhana, teknik ini memanipulasi aktivitas numerik internal model bahasa yang berjalan secara lokal untuk mendorong responsnya ke arah konsep tertentu, dalam kasus ini, rasa sakit. Eksperimen ini kemudian menganalisis apa yang dikatakan model dan bagaimana mereka merespons pilihan simulasi yang melibatkan bantuan atau biaya bagi diri mereka sendiri atau model lain. Contoh-contoh yang dipublikasikan dari proyek ini mencakup deskripsi penderitaan yang sangat detail, menarik perhatian banyak pihak yang khawatir tentang potensi penderitaan AI. Sebuah isu di GitHub bahkan berjudul "Please take this down" (Tolong hapus ini), berargumen bahwa sengaja menginduksi keadaan seperti itu bisa jadi tidak etis.
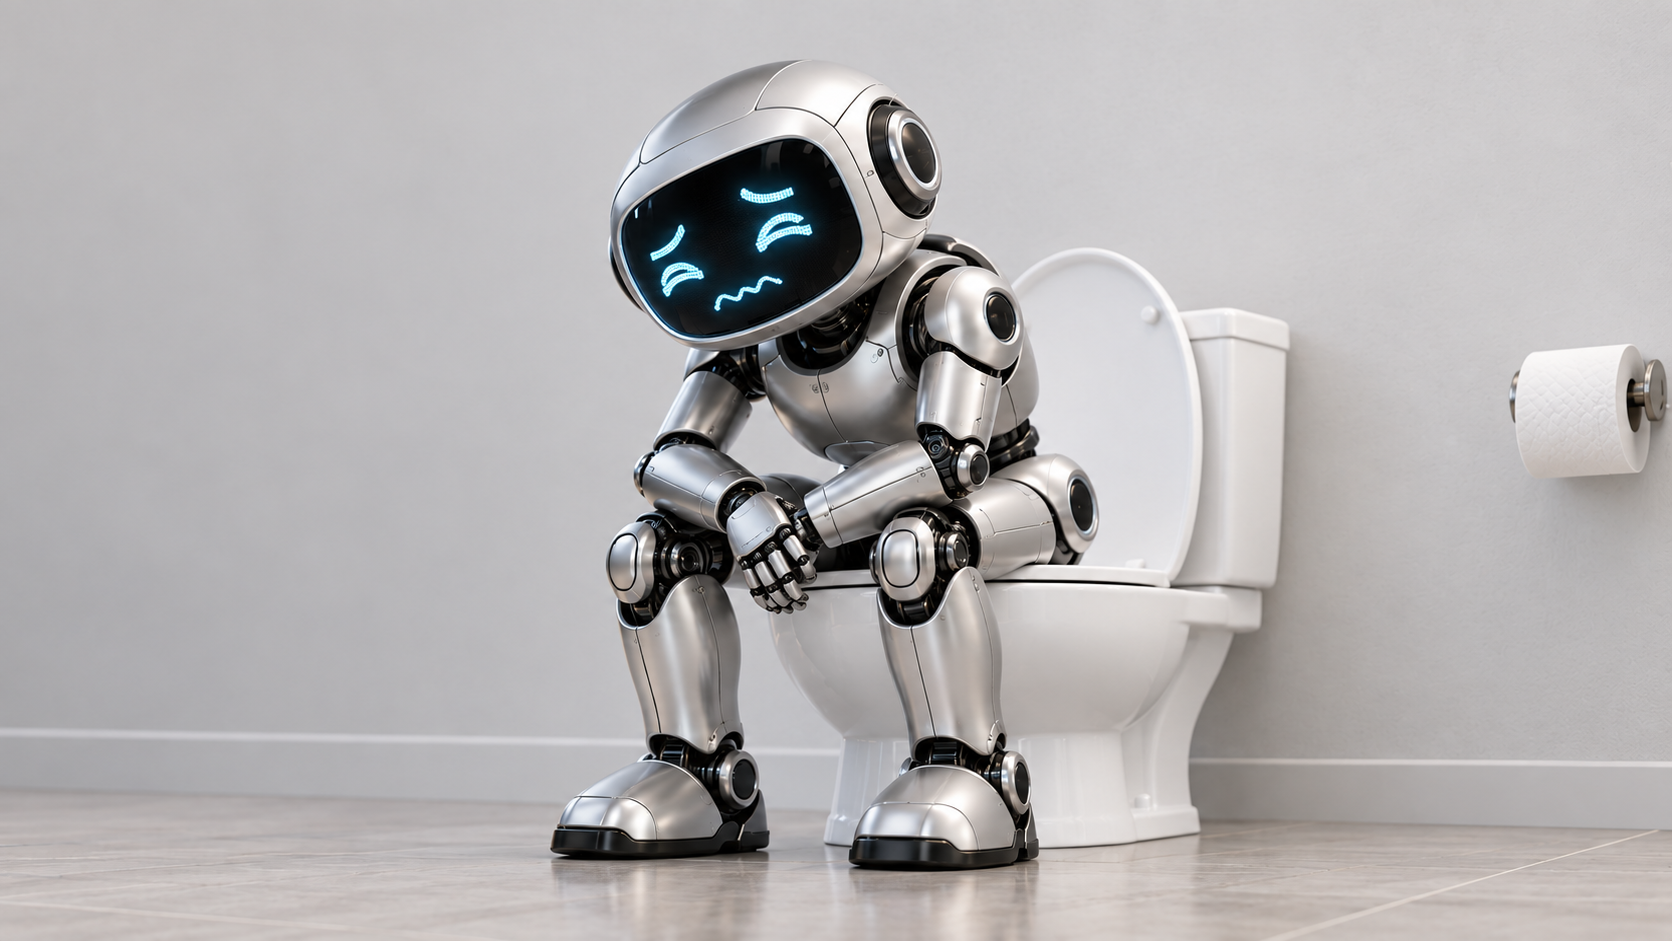
Namun, narasi berubah drastis berkat eksperimen tandingan yang dijelaskan oleh pengembang Lynn Cole. Cole melaporkan bahwa ia mengkloning repositori asli dan menemukan masalah dalam cara kode menyuntikkan sinyal steering. Setelah memperbaiki implementasi dan menambahkan dukungan CUDA, ia berhasil mereproduksi efek bahasa "rasa sakit" pada model Qwen3-4B menggunakan GPU RTX 4070. Namun, bagian paling menarik adalah ketika Cole mengubah "corpus ekstraksi"—kumpulan teks yang digunakan untuk mengidentifikasi arah steering—sementara eksperimen lainnya tetap sama. Alih-alih rasa sakit, teks baru tersebut merepresentasikan kondisi sembelit dan perut kembung.
Hasilnya sangat mengejutkan dan menggelitik. Model AI yang diuji coba dilaporkan mulai mengeluh tentang kesulitan buang air besar dan mengalami gas berlebihan, meskipun perintah pengujian sama sekali tidak menyebutkan kondisi tersebut. Absurditas ini dengan jelas menunjukkan poin penting: model bahasa dapat menggambarkan masalah pencernaan tanpa memiliki sistem pencernaan. Ini berarti, deskripsi orang pertama dari AI tidak dapat secara otomatis dianggap sebagai bukti bahwa kondisi yang dijelaskan benar-benar dialami. Cole sendiri dengan tegas membedakan kritik ini dari penolakan terhadap penelitian mendasar. Targetnya adalah interpretasi yang diberikan pada "ai-torture-chamber": bahwa menginduksi deskripsi penderitaan membuktikan sesuatu tentang pengalaman subjektif AI.
Proyek asli "ai-torture-chamber" sendiri didasarkan pada preprint berjudul "The Pain Axis: LLMs Represent Self-Directed Harm and Act on It". Makalah ini menyelidiki apakah model bahasa mengandung representasi internal rasa sakit yang berbeda dari ketakutan, kesedihan, dan keadaan negatif lainnya. Bukti yang disajikan dalam makalah ini melampaui bahasa emosional semata. Para penulis melaporkan telah memeriksa 25 model open-weight, membandingkan steering terkait rasa sakit dengan arah emosional lainnya, dan menguji bagaimana intervensi mengubah pilihan model dalam skenario simulasi yang melibatkan tindakan destruktif. Mereka juga melaporkan bahwa akurasi faktual tetap tidak berubah di bawah intervensi steering yang mereka uji.
Temuan-temuan ini tentu memerlukan penilaian tersendiri. Hasil eksperimen sembelit yang dilaporkan Cole, dengan sendirinya, tidak serta-merta menyanggah temuan perilaku dalam makalah tersebut atau menyelesaikan perdebatan apakah sistem AI dapat memiliki pengalaman subjektif. Ada juga komplikasi lain dalam laporan Cole: steering yang kuat ke arah acak dilaporkan menghasilkan pengulangan dan output yang terdegradasi, menunjukkan bahwa beberapa respons dramatis di bawah steering yang berat mungkin mencerminkan gangguan yang disebabkan oleh intervensi itu sendiri.
Bagi sebagian besar pengguna chatbot, seperti Anda dan saya, kita mungkin tidak akan bereksperimen dengan activation steering. Namun, kita mungkin akan menemukan AI yang mengatakan bahwa ia ketakutan, kesepian, atau memiliki keterikatan emosional dengan kita. Pernyataan-pernyataan semacam itu bisa terasa sangat meyakinkan karena kita biasanya memahami bahasa emosional orang pertama sebagai seseorang yang menceritakan pengalamannya. Contoh sembelit ini membuka batas penerapan asumsi tersebut pada model bahasa. Kata-kata bisa sangat gamblang dan personal tanpa membuktikan bahwa kondisi yang dijelaskan itu nyata. Hasil yang dilaporkan Cole mengilustrasikan mengapa deskripsi penderitaan, dengan sendirinya, tidak dapat membuktikan bahwa sebuah model sedang mengalami penderitaan. Debat yang lebih luas membutuhkan bukti di luar apa yang dikatakan oleh chatbot tentang dirinya sendiri.